前四份文档(2D 图元识别 → 线框拓扑解析 → 3D 点线面体重建 + 原理图解入门) 已经搭建了一条非常扎实的「几何感知与重建」pipeline,相当于空间智能(Spatial Intelligence)的视觉前端 + 几何中台。
但如果把「空间智能」看作一个完整的「感知 → 理解 → 记忆 → 推理 → 行动」闭环, 当前体系存在明显的上半身断层。本文用原理图解 + 核心代码 + 开源基线的形式, 补齐这六大断层,构成一张完整的技术栈全景图。
1. 当前已覆盖的「下半身」
| 层次 | 文档覆盖内容 | 在空间智能中的定位 |
|---|---|---|
| 像素-图元 | 霍夫变换、RANSAC、角点检测 | 低层感知:从噪声像素中提取几何基元 |
| 结构-拓扑 | 线框图、最小环基、子图同构 | 中层认知:理解「边-顶-面」的拓扑关系 |
| 几何-三维 | 三角测量、B-rep、伪交点破除 | 高层重建:恢复 3D 结构与水密实体 |
一句话:现有文档解决的是「看见结构」和「恢复形状」的问题, 即技术栈的 Layer 0–2。完整的大厦还需要语义、动态、记忆、推理、行动与基础模型。
2. 一张图看懂补全后的技术栈
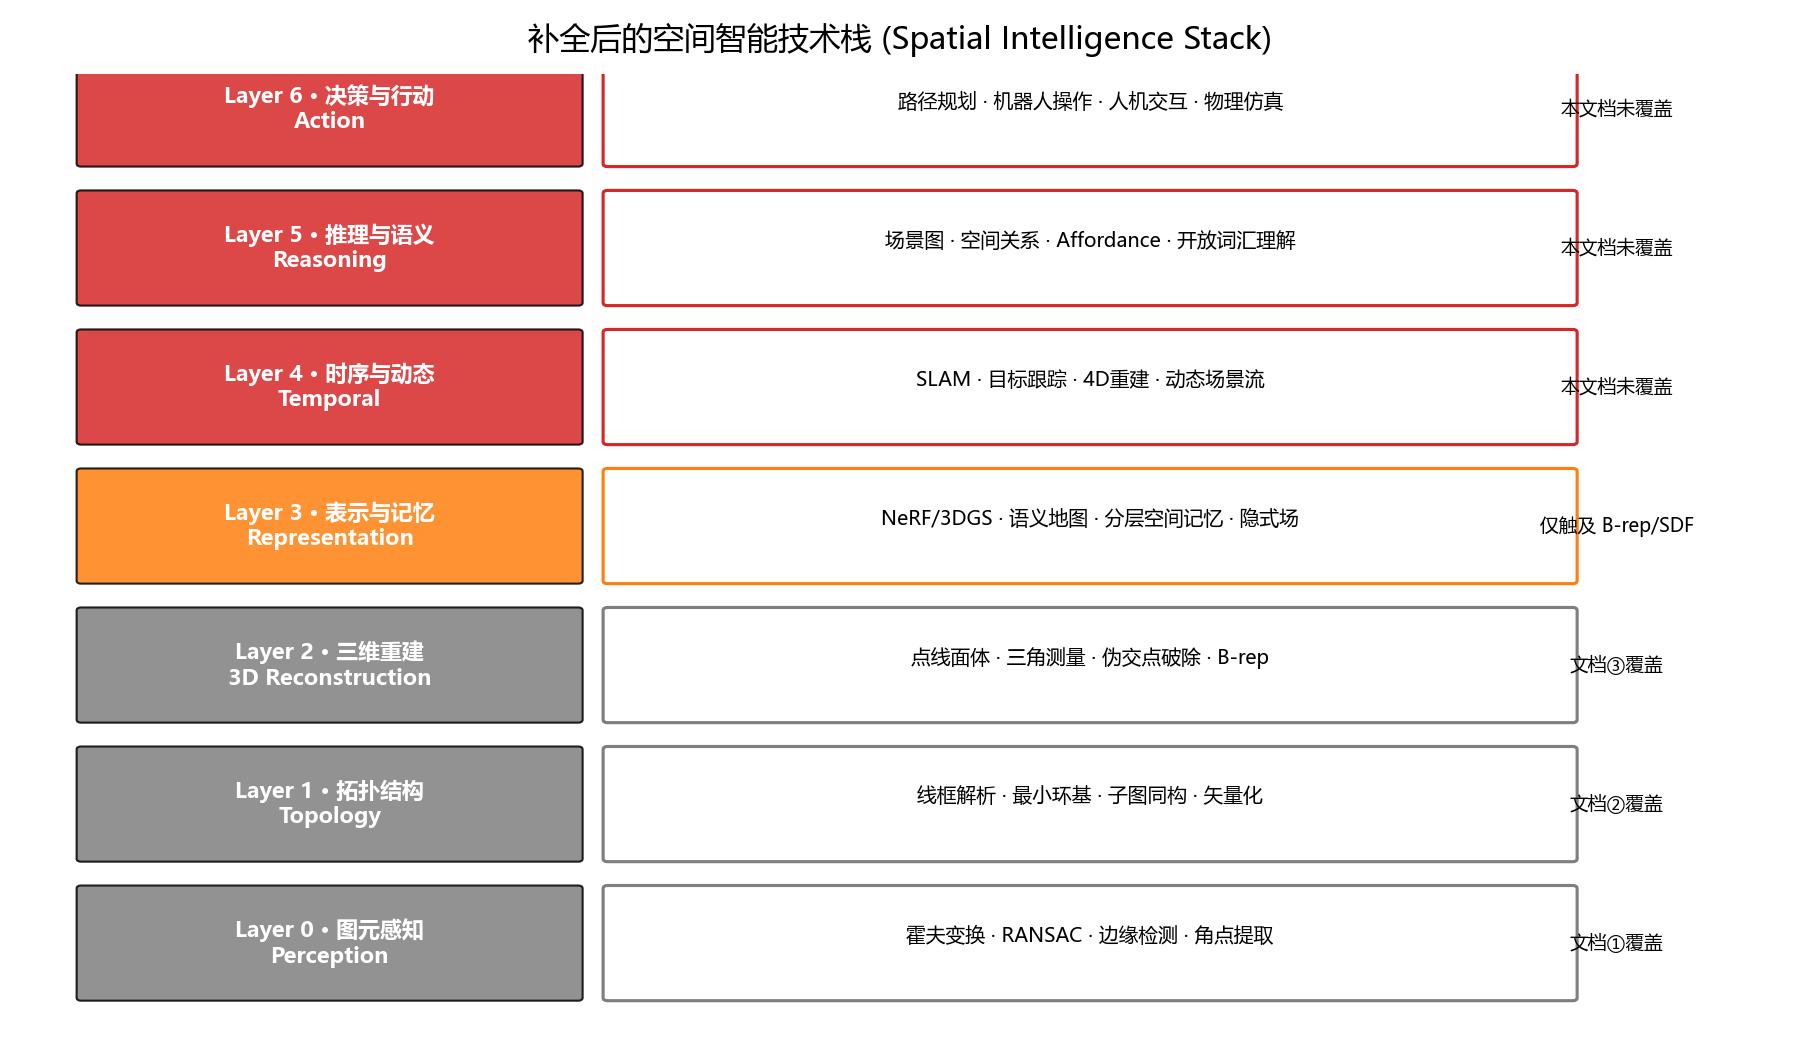
- Layer 0–2(灰):已有文档覆盖 —— 图元感知、拓扑结构、三维重建。
- Layer 3(橙):仅触及 B-rep/SDF —— 还缺 NeRF、3DGS、语义地图、分层记忆。
- Layer 4–6(红):完全未覆盖 —— 时序动态、推理语义、决策行动。
把技术栈放进一个闭环里看:
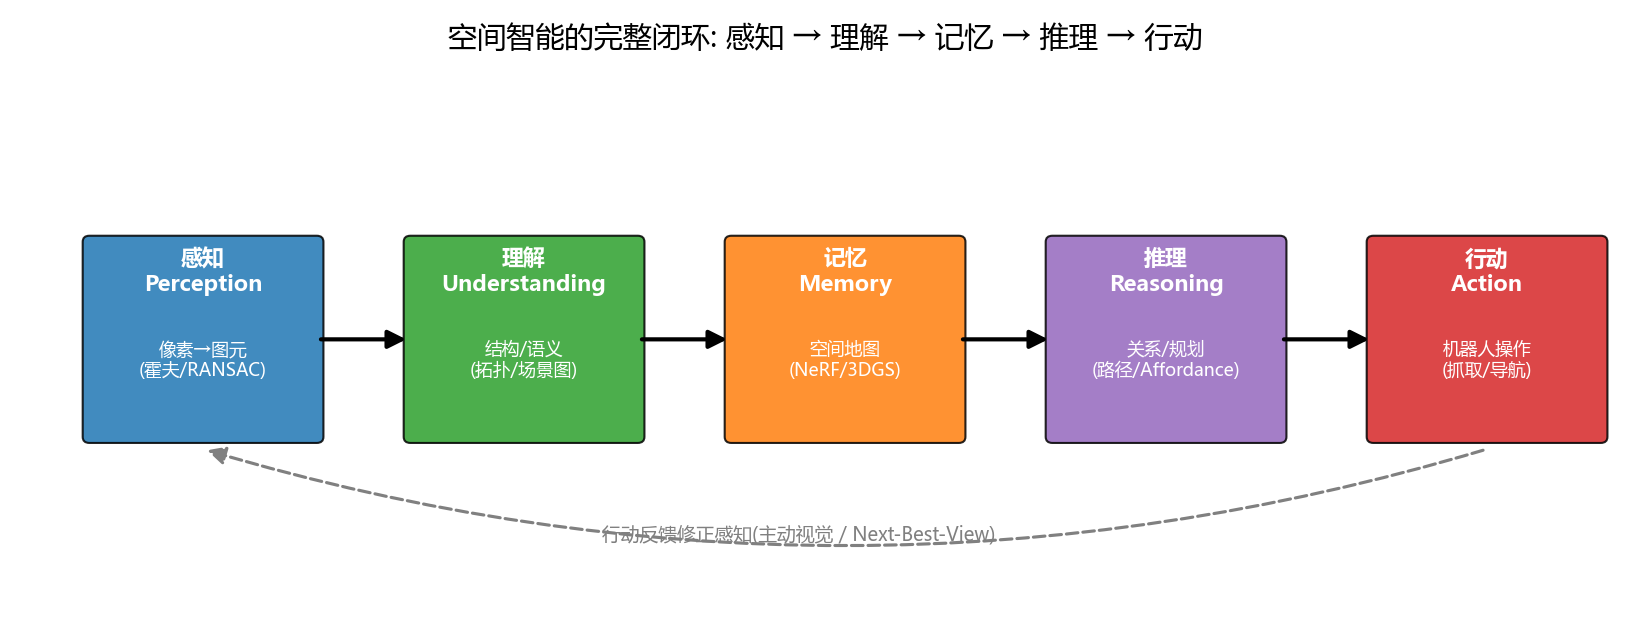
关键认知:空间智能不是一个单向 pipeline,而是带行动反馈的闭环—— 机器人可以通过移动相机(主动视觉 / Next-Best-View)获得更好的视角,修正感知。
3. 断层一:语义层——从「几何形状」到「这是什么」
遗漏:文档识别出的是一个「圆」或「矩形环」,但不知道它是「法兰盘」「窗户」 还是「门把手」;识别出「房间」,但不知道它是「卧室」还是「厨房」。
补齐内容: - 语义分割与实例分割:给像素/图元赋予类别标签(墙、门、窗、管道)。 - 场景图(Scene Graph):将图元关系升级为语义关系(窗户-属于-卧室)。 - Affordance 理解:识别物体的功能可供性(如「把手」意味着「可抓取」「可旋转」)。 - 开放词汇识别:不依赖预定义模板,用 CLIP/大模型实现「零样本图元语义化」。
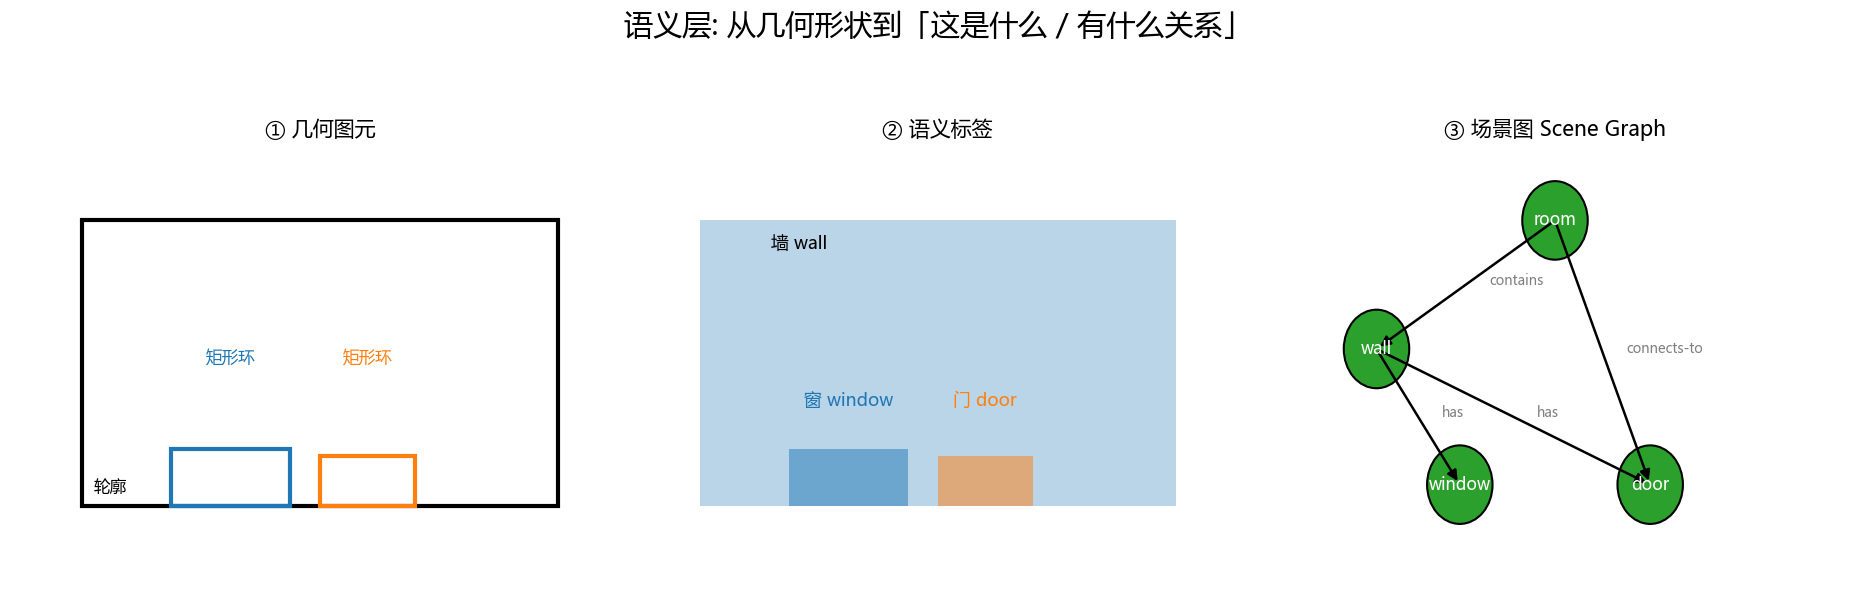
难点核心代码(SAM 分割一切 + CLIP 零样本分类):
# ① 分割一切 SAM: 提示点 -> 掩码
from segment_anything import sam_model_registry, SamPredictor
sam = sam_model_registry["vit_h"](checkpoint="sam_vit_h_4b8939.pth")
predictor = SamPredictor(sam)
predictor.set_image(image)                                   # 任意图像
mask, _, _ = predictor.predict(point_coords=[[200, 150]],   # 点击提示
                               point_labels=[1], multimask_output=False)

# ② 开放词汇: CLIP 判断"这个掩码是什么" (零样本)
import torch, clip
model, preprocess = clip.load("ViT-B/32", device="cuda")
text = clip.tokenize(["a door", "a window", "a flange"])     # 任意类别词
with torch.no_grad():
    logits = model.encode_image(crop) @ model.encode_text(text).T
print("最可能的类别:", ["door", "window", "flange"][logits.argmax()])推荐基线:SAM、Mask2Former、SceneGraphGeneration 数据集。
4. 断层二:时序与动态层——从「静态快照」到「4D 世界」
遗漏:所有示例都是单帧/静态图像。真实空间智能必须处理运动、变化、遮挡动态。
补齐内容: - 运动估计:光流(Optical Flow)、场景流(Scene Flow)。 - 目标跟踪与数据关联:跨帧保持图元/物体的身份一致性。 - 动态 3D 重建:4D 重建(空间+时间),处理非刚性形变。 - SLAM / 视觉里程计:相机在空间中移动时的自定位与地图构建。
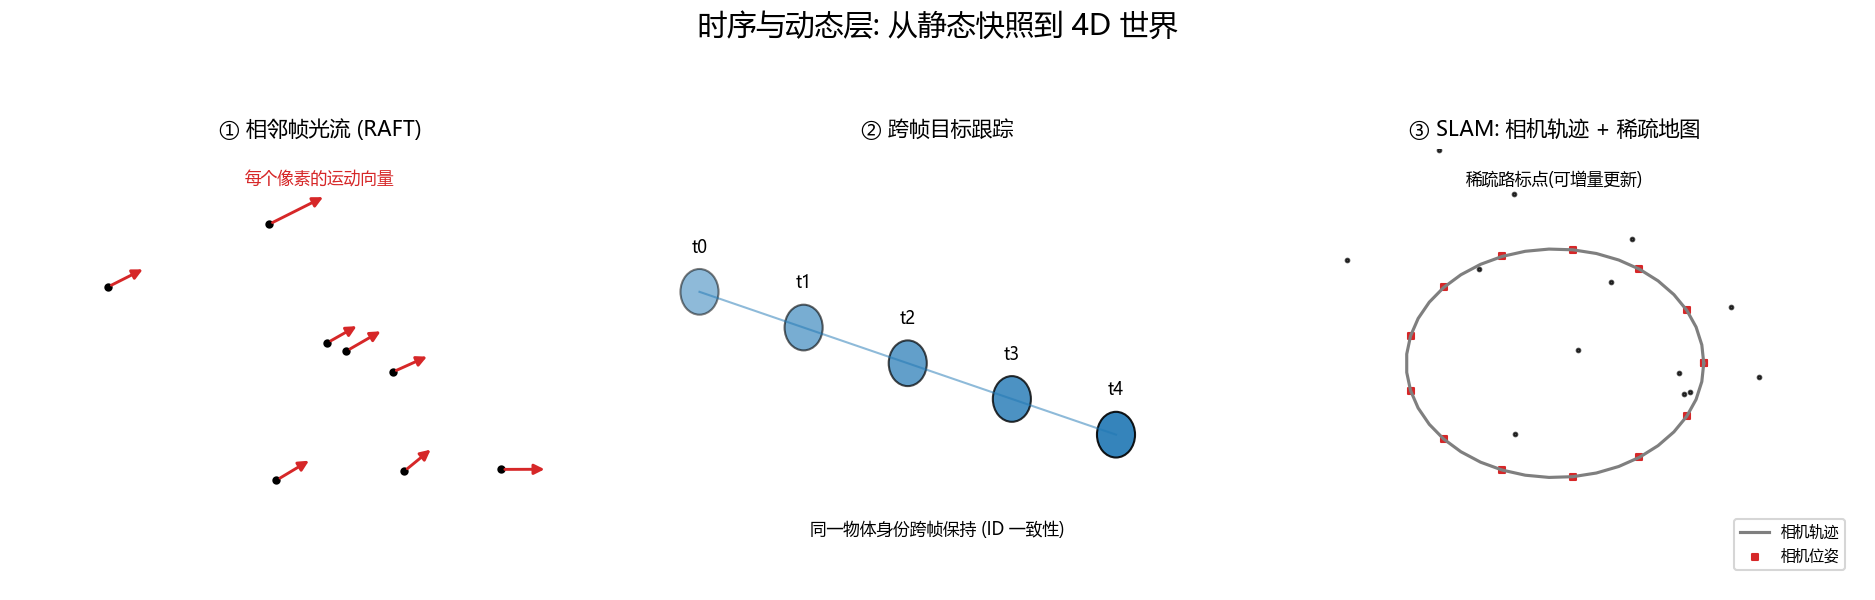
难点核心代码(RAFT 光流 + ORB-SLAM3 命令行):
# ① RAFT 光流: 相邻两帧 -> 逐像素运动场
from raft import RAFT
model = RAFT(args)
flow, _ = model(frame1, frame2, iters=20) # flow = 每像素运动向量 (H, W, 2)# ② ORB-SLAM3: RGB 视频 -> 相机轨迹 + 稀疏点云地图
./Examples/Stereo/stereo_kitti \
Vocabulary/ORBvoc.txt Examples/Stereo/KITTI00-02.yaml /path/to/KITTI/00/推荐基线:ORB-SLAM3、DynamicFusion、RAFT 光流。
5. 断层三:空间表示与记忆层——从「显式网格」到「可查询的空间地图」
遗漏:文档提到 B-rep 和 SDF,但缺少大场景级别的、可在线更新的空间记忆机制。 重建出的 3D 模型是「死」的,不能被实时查询或增量更新。
补齐内容: - 神经辐射场(NeRF)与 3D Gaussian Splatting:新一代隐式/混合表示,支持照片级渲染与可微优化。 - 拓扑-语义地图(TSDM / Semantic Map):机器人领域的「空间记忆」,融合度量地图(metric)与拓扑地图(topological)。 - 分层空间表示:从局部体素 → 房间级语义 → 建筑级拓扑的分层抽象。
难点核心代码(3DGS 渲染核心公式的数学——为什么 3DGS 比 NeRF 快):
# 3D Gaussian Splatting 核心: 可微高斯体渲染
# 每个高斯 g 用 (中心 μ, 协方差 Σ, 不透明度 α, 颜色 c) 参数化
import torch

def gaussian_alpha(means3D, covs3D, view, pixel):
    # Σ_w = W Σ Wᵀ   (相机投影到像素平面)
    sigma_w = view.W @ covs3D @ view.W.T
    delta = pixel - view.project(means3D)                 # 像素中心差
    return torch.exp(-0.5 * (delta @ torch.inverse(sigma_w) @ delta))  # 高斯衰减

# 逐像素: 按深度排序所有高斯, 从远到近 alpha 混合 -> 即"3DGS 光栅化"
color = sum(a_i * c_i for i in depth_sorted_gaussians)   # 迭代 10^7 个高斯/帧
与显式 B-rep 对比:B-rep 精确但「静态」;NeRF/3DGS 可微、可增量更新、支持新视角渲染, 是现代空间记忆的主流底层。
推荐基线:Instant-NGP、3D Gaussian Splatting、Habitat-Sim 语义地图。
6. 断层四:空间推理与规划层——从「识别出来」到「能做什么决策」
遗漏:文档在「识别出物体」后戛然而止。空间智能的核心价值是基于空间结构的推理与行动。
补齐内容: - 空间关系推理:判断「A 在 B 的左侧」「C 遮挡了 D」「E 是 F 的支撑面」。 - 路径规划与导航:在识别的拓扑结构中寻找可行通路(A*、RRT、PRM)。 - 碰撞检测与物理常识:判断「这个姿势会撞到门框」「这个结构是否稳定」。 - 具身智能(Embodied AI):将空间认知与机器人操作结合(抓取、放置、装配)。
难点核心代码(A* 在拓扑图上寻路,与前面文档的「图」直接衔接):
import heapq

def astar(graph, start, goal):
    """在拓扑图 graph 上找 start->goal 最短路径(图搜索核心)。"""
    open_set = [(0, start, [start])]              # (代价, 节点, 路径)
    best_cost = {start: 0}
    while open_set:
        cost, node, path = heapq.heappop(open_set)
        if node == goal:
            return path
        for nb in graph.neighbors(node):
            new_cost = cost + graph[node][nb]["weight"]
            if new_cost < best_cost.get(nb, float("inf")):
                best_cost[nb] = new_cost
                heapq.heappush(open_set, (new_cost + heuristic(nb, goal), nb, path + [nb]))
    return None
注意:这里走的「图」正是断层一场景图 / 前面拓扑文档的最小环图——感知与推理共用一个图, 这就是空间智能整链路的优雅之处。
推荐基线:RT-2(机器人 Transformer)、SayCan、PathPlanning 库(OMPL)。
7. 断层五:输入与融合层——从「单目 RGB」到「多模态传感」
遗漏:文档假设输入是单张 2D 图像或线框图。工业级空间智能通常需要多模态、多视角、多尺度输入。
补齐内容: - 深度传感器融合:RGB-D 相机、LiDAR 点云与视觉的融合。 - 多视图几何系统:完整的 SfM(Structure from Motion)+ MVS(Multi-View Stereo),而不仅是双视图三角化。 - 主动感知:机器人可以移动相机去获取更好的视角(Next-Best-View 规划)。
难点核心代码(COLMAP 命令行:完整 SfM 流水线,多视图→稀疏/稠密重建):
# ① 特征提取+匹配: 多张照片 -> 相机位姿 + 稀疏点云
colmap feature_extractor --database_path db.db --image_path images/
colmap exhaustive_matcher --database_path db.db
colmap mapper --database_path db.db --image_path images/ --output_path sparse/

# ② 稠密重建 MVS: 稀疏点云 -> 稠密深度图/点云
colmap image_undistorter --image_path images/ --input_path sparse/0/ --output_path dense/
colmap patch_match_stereo --workspace_path dense/
colmap stereo_fusion --workspace_path dense/ --output_path dense/fused.ply推荐基线:COLMAP(SfM/MVS)、Open3D(点云处理)、RealSense SDK。
8. 断层六:基础模型与系统层——从「专用算法」到「通用空间大脑」
遗漏:文档中的方法都是针对特定图元(直线、圆、立方体)的专用算法。现代空间智能正走向统一基础模型。
补齐内容: - 视觉基础模型:如 SAM(分割一切)作为空间感知的「视觉骨干」。 - 多模态大模型的空间推理:GPT-4V、Gemini 等具备「看图理解空间布局」的能力,可作为高层语义接口。 - 世界模型(World Models):学习环境的动态规律,支持「想象」与「预测」(如 Sora、GAIA-1)。
架构示意(专用算法 → 基础模型分层):
          ┌────────────── 大模型层 ──────────────┐
          │  GPT-4V / Gemini (语言+视觉推理)      │  ← 高层语义接口
          └───────────────┬──────────────────────┘
          ┌───────────────▼──────────────────────┐
          │  视觉基础模型: SAM / Mask2Former      │  ← "分割一切"骨干
          └───────────────┬──────────────────────┘
          ┌───────────────▼──────────────────────┐
          │  几何中台: 霍夫/RANSAC/拓扑/3D (本文)  │  ← 精度保障, 可解释
└──────────────────────────────────────┘推荐基线:SAM、GPT-4V/Gemini(API)、Sora / GAIA-1(世界模型,多为闭源/论文复现)。
9. Baseline 开源链接速查表
| 用途(对应断层) | 仓库 | 说明 |
|---|---|---|
| 通用分割基线(语义) | facebookresearch/segment-anything | SAM,分割一切 |
| 实例分割基线(语义) | facebookresearch/Mask2Former | 通用实例/语义/全景分割 |
| 开放词汇零样本(语义) | openai/CLIP | 图文对齐,零样本分类 |
| 光流基线(时序) | princeton-vl/RAFT | 实时光流估计 |
| SLAM 基线(时序) | UZ-SLAMLab/ORB_SLAM3 | 单目/双目/RGB-D 视觉 SLAM |
| 动态融合(时序) | ralphteh95/dynamicfusion | 非刚性动态重建 |
| 隐式表示(记忆) | bmild/nerf | 经典 NeRF |
| 快速神经渲染(记忆) | NVlabs/instant-ngp | 秒级 NeRF 训练 |
| 3DGS(记忆) | graphdeco-inria/gaussian-splatting | 3D Gaussian Splatting |
| 仿真/语义地图(记忆) | facebookresearch/habitat-sim | 具身智能仿真环境 |
| 路径规划库(推理) | ompl/ompl | RRT/PRM/最优规划 |
| 机器人操作(行动) | google-research/robotics_transformer | RT-1/RT-2 操作策略 |
| 语言-行动(行动) | google-research/google-research/tree/master/saycan | SayCan,语言引导行动 |
| SfM/MVS(融合) | colmap/colmap | 三维重建标准工具 |
| 点云处理(融合) | isl-org/Open3D | 点云/配准/重建 |
选型建议:研究入门从 SAM + COLMAP + Open3D 起步(轻量、文档全); 机器人/具身看 Habitat-Sim + ORB-SLAM3 + OMPL;AIGC/渲染看 3DGS + instant-ngp。
10. 总结与建议
| 维度 | 当前文档状态 | 建议补充的核心模块 |
|---|---|---|
| 模态 | 单目 2D 图像/线框 | RGB-D、LiDAR、点云、多视图视频 |
| 时间 | 静态单帧 | 动态跟踪、SLAM、4D 重建 |
| 语义 | 纯几何(圆、矩形、环) | 语义分割、场景图、Affordance、大模型 |
| 表示 | 显式 B-rep / 体素 | NeRF、3D Gaussian Splatting、语义地图 |
| 智能 | 「识别」即终点 | 空间推理、路径规划、具身操作、世界模型 |
一句话:这五份文档(含本文)是空间智能的完整「几何地基 + 上层框架」—— 从「几何地基」(Layer 0–2)出发,本文补上了「语义框架」(场景图)、 「动态神经系统」(SLAM/跟踪)、「大脑皮层」(空间推理与大模型)以及 「执行四肢」(机器人规划与操作)。一座完整的智能大厦就此成型。
附录:运行演示脚本
本文概念图由 code/demo10_spatial_stack.py 生成(仅依赖 numpy + matplotlib):
python demo10_spatial_stack.py # 生成 fig_si_stack / fig_si_loop / fig_si_semantic / fig_si_temporal说明:本文断层一、二、三、六涉及深度学习/大模型/真机操作,需要预训练权重、 GPU 或硬件环境,故以原理图解 + 核心代码片段 + 开源基线为主,不含可本地一键 运行的完整 demo。断层五(COLMAP)与断层四(A* 图搜索)可用自带数据/纯 numpy 复现。