本文档是《图形学与 AI 基础》的工程实践续篇:前六册讲了「原理与算法」, 本文解决「模型到底怎么练好」的工程问题。
核心逻辑链(也是本文目录顺序):
``
数据预处理(第2章) → 参数设置(第1章) → 训练执行(第3章) → 效果评价(第4章) → 问题排查(第5章)``每个主题均配原理公式、可直接运行的 Python 代码及演示图生成脚本 (
code/demo20–27*.py,全部已实测通过)。
1. 模型参数设置
1.1 超参数空间表
超参数是训练前设定的、不由梯度更新决定的参数。常见取值经验:
| 超参数 | 典型范围 | 影响 | 经验建议 |
|---|---|---|---|
| 学习率 LR | 1e-5 ~ 1e-1 | 收敛速度与稳定性 | 过高震荡、过低停滞;常配 Warm-up |
| Batch Size | 8 ~ 512 | 梯度噪声/内存 | 大 batch 稳但可能泛化差;影响 LR 基准 |
| Epochs | 视数据量 | 训练时长 | 配合早停动态决定 |
| 正则(L2) | 1e-5 ~ 1e-2 | 抑制过拟合 | 越大越平滑 |
| Dropout | 0.1 ~ 0.5 | 随机失活防过拟合 | 越大抑制越强 |
关键推导:Batch Size 与学习率耦合——有效学习率 ≈
lr × batch_size / base_batch, 增大 batch 时应按比例放大 lr(线性缩放法则)。
1.2 参数初始化策略:Xavier 与 He
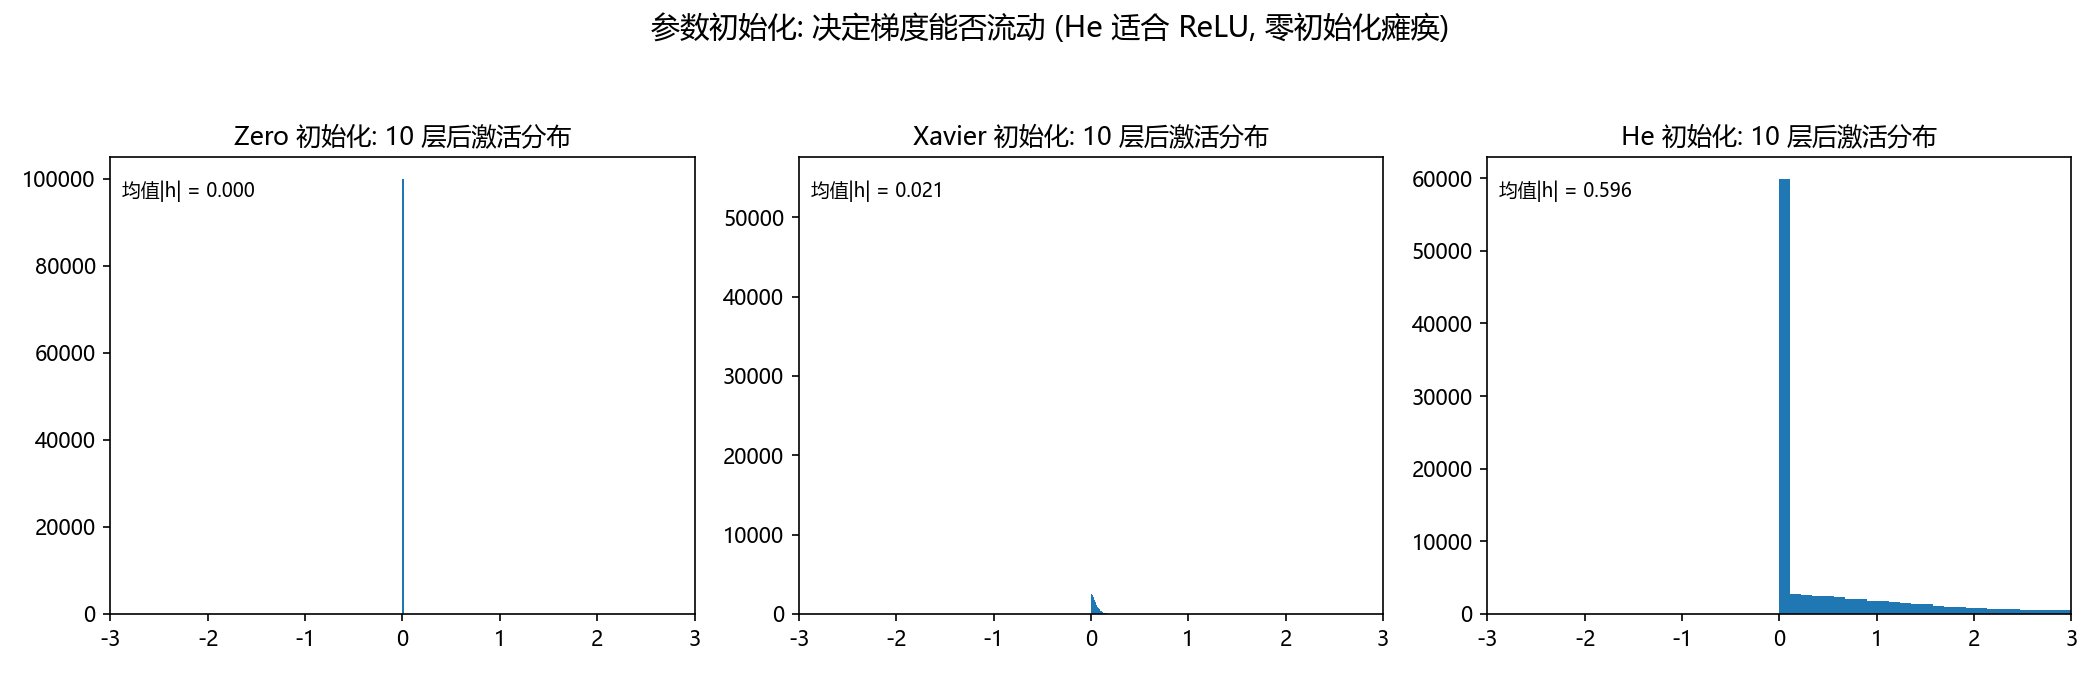
网络初始权重决定梯度能否流动。核心思想:让每层输出的方差保持稳定,避免逐层放大或衰减。
Xavier(Glorot)初始化(适合 Sigmoid/Tanh):
He 初始化(适合 ReLU,修正 ReLU 把负半轴压零导致的方差减半):
推导要点:设每层输出方差守恒
Var(z_l) ≈ Var(z_{l-1}),对 Sigmoid 需Var(W)≈1/n_in, 对 ReLU(约一半输出为 0)需Var(W)≈2/n_in——这就是 He 比 Xavier 的方差大 2 倍的原因。 零初始化会使同一层所有神经元梯度对称,永远学不出不同特征。
# PyTorch 初始化示例
import torch.nn as nn
def init_weights(m):
    if isinstance(m, nn.Linear):
        nn.init.kaiming_normal_(m.weight, mode="fan_in", nonlinearity="relu")  # He
        # nn.init.xavier_normal_(m.weight)                                     # Xavier
1.3 超参数搜索策略
- 网格搜索(Grid Search):遍历所有超参数组合。优点:穷尽、可复现;缺点:组合数随维度爆炸(维度灾难)。
- 随机搜索(Random Search):从分布中随机采样组合。经验证明:同样预算下,随机搜索比网格更优——因为通常只有少数超参数真正重要。
from sklearn.model_selection import GridSearchCV, RandomizedSearchCV
# grid = GridSearchCV(est, param_grid={"lr":[1e-3,1e-2], "dropout":[0.2,0.5]})
# rand = RandomizedSearchCV(est, param_distributions=dist, n_iter=50)
2. 数据预处理
2.1 数据清洗与特征工程
数据清洗:缺失值(删除/插值/填充)、异常值(3σ / IQR 检出)、重复样本去重。
特征工程(尺度统一是关键):
| 方法 | 公式 | 适用 |
|---|---|---|
| 标准化(Z-Score) | $x'=\dfrac{x-\mu}{\sigma}$ | 数据近似正态,量纲不同 |
| 归一化(Min-Max) | $x'=\dfrac{x-\min}{\max-\min}$ | 有明确上下界 |
| One-Hot 编码 | 类别 → 0/1 向量 | 无序类别 |
| Label 编码 | 类别 → 整数 | 有序类别 |
from sklearn.preprocessing import StandardScaler, MinMaxScaler, OneHotEncoder
X = StandardScaler.fit_transform(X) # 用训练集 fit, 再 transform 验证/测试反直觉点:Min-Max 对离群点极敏感(一个极端值拖垮整体);Z-Score 更稳健。 必须在训练集上拟合 scaler,绝不能用全量数据(防数据泄漏)。
2.2 数据增强
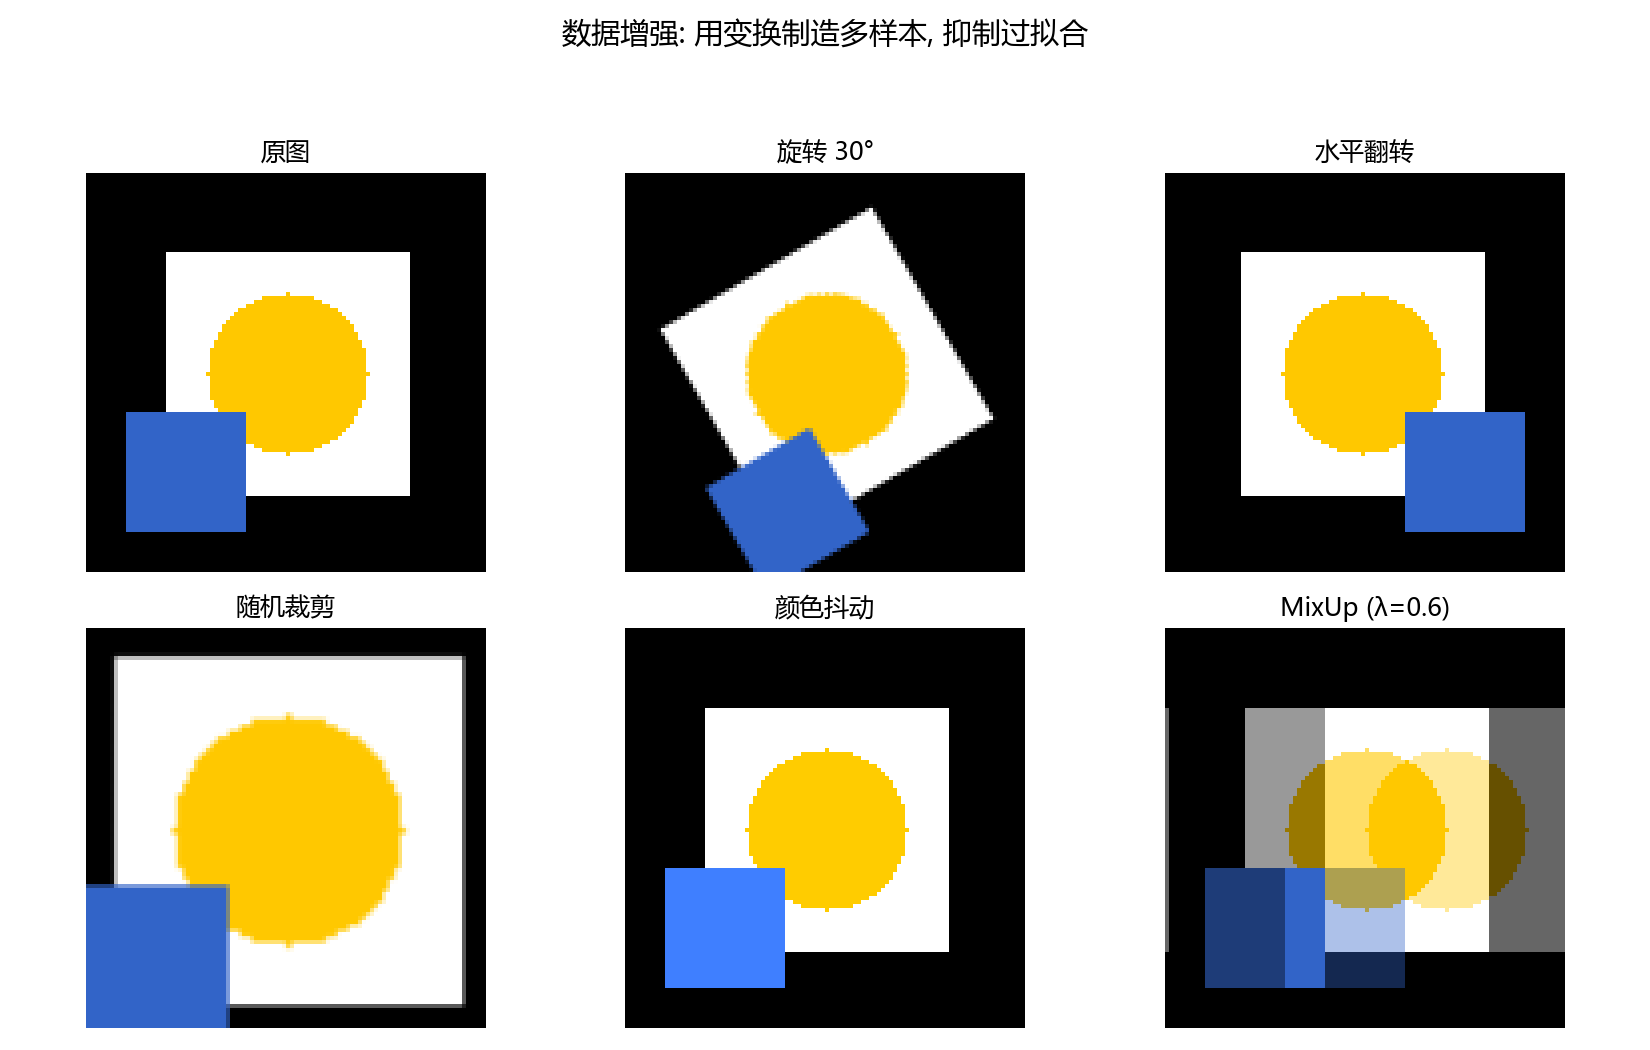
用变换制造"等价但多样"的训练样本,是抑制过拟合最有效的手段之一:
- 几何变换:旋转、翻转、裁剪、缩放、平移;
- 颜色抖动:亮度/对比度/色相扰动;
- MixUp / CutMix:样本与标签的凸组合或块剪切混合。
MixUp 公式(λ 从 Beta 分布采样):
# torchvision 数据增强
from torchvision import transforms
aug = transforms.Compose([
    transforms.RandomRotation(15), transforms.RandomHorizontalFlip,
    transforms.RandomResizedCrop(224), transforms.ColorJitter(0.2, 0.2, 0.2),
])
2.3 类别不平衡处理
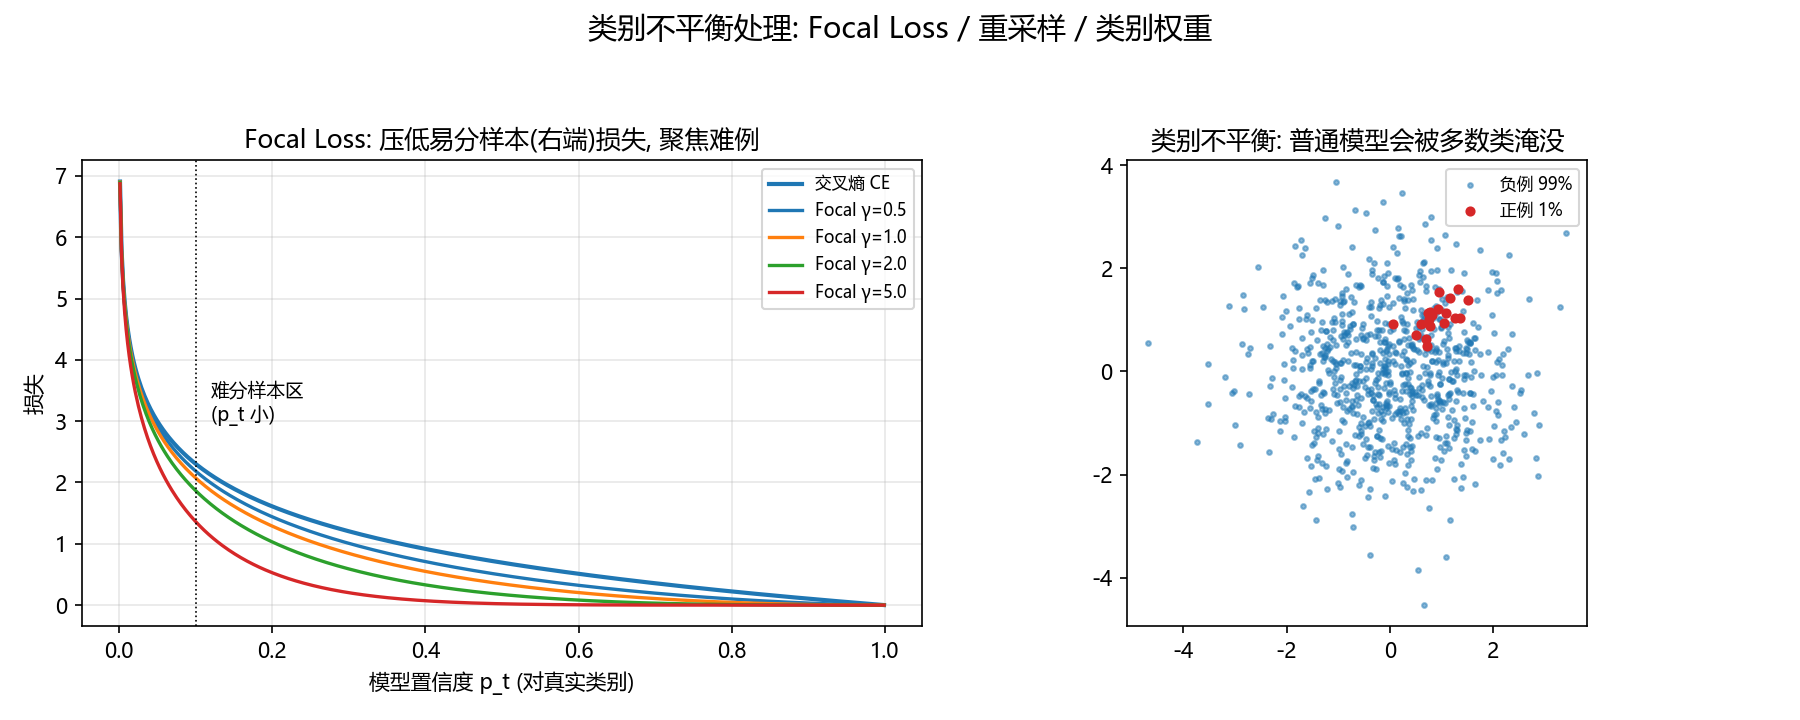
当某类样本极少(如缺陷检测中正例占 1%),模型会被多数类淹没。三类解法:
- 重采样:欠采样多数类 / 过采样少数类(SMOTE 合成);
- 类别权重:损失中对少数类样本加权
w_i = N/(K·n_k); - Focal Loss(何恺明,RetinaNet):压低易分样本的损失,聚焦难例:$$FL(p_t) = -(1-p_t)^\gamma \log(p_t)$$
当 p_t→1(易分对),权重 (1-p_t)^γ→0,贡献被抑制;γ 越大抑制越强。
def focal_loss(p, gamma=2.0):      # p = 模型对真实类别的置信度
    return -(1 - p) ** gamma * np.log(np.clip(p, 1e-6, 1))
2.4 数据划分策略
- K-Fold 交叉验证:把数据均分 K 份,轮流做验证,K 次结果取平均——小数据集最可靠;
- 分层抽样(Stratified):划分时保持各类比例与全量一致,避免某一折恰好缺少数类。
from sklearn.model_selection import KFold, StratifiedKFold, train_test_split
skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
3. 训练标准流程
3.1 Train / Validation / Test 黄金法则
- Train:学参数;Validation:调超参/选模型/早停;Test:只评一次最终性能。
- 铁律:Test 绝不参与任何决策,否则就是"作弊"(数据泄漏);Validation 反复使用多次后也会过拟合它。
3.2 训练循环与学习率调度
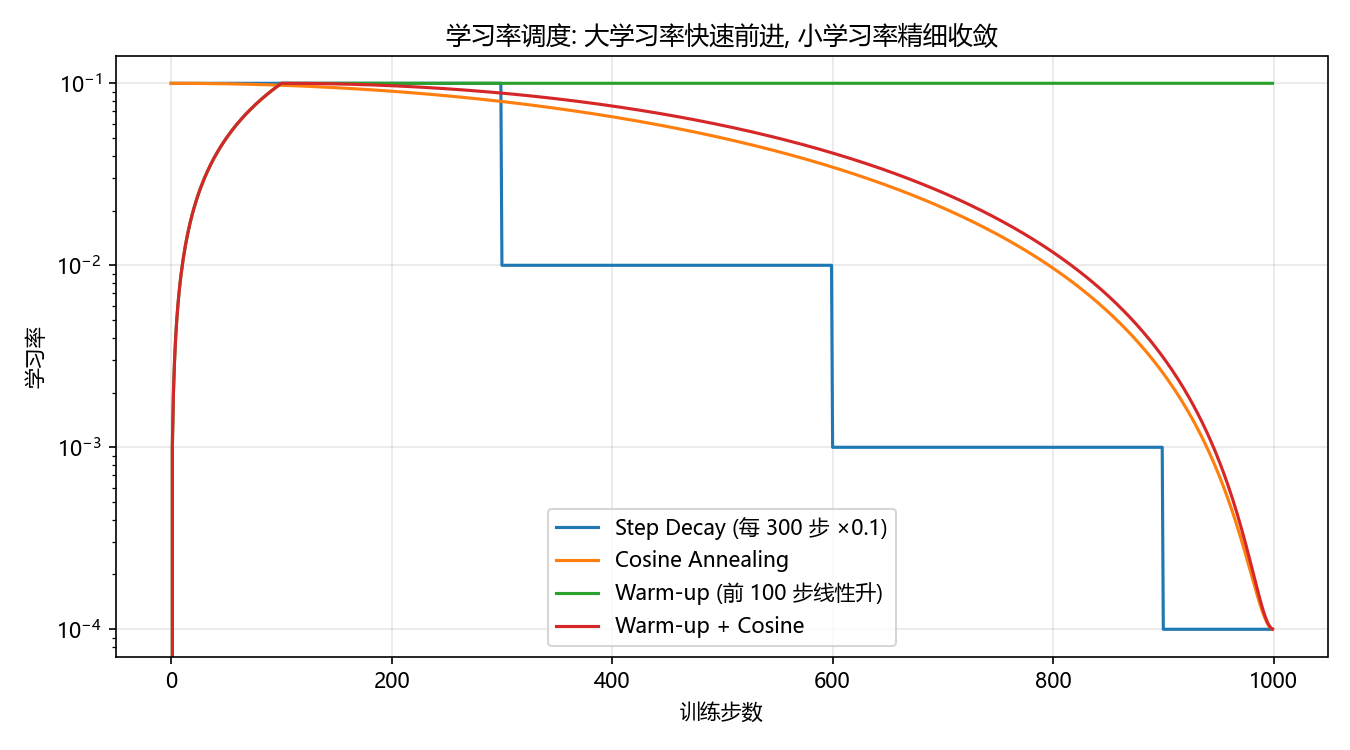
标准训练循环 = 前向传播 → 损失计算 → 反向传播 → 参数更新。
学习率调度(训练中动态调整 LR): - Step Decay:每 N 步乘一个衰减因子(如 ×0.1); - ReduceLROnPlateau:验证损失停滞时自动降 LR; - Cosine Annealing:沿余弦曲线平滑衰减到最小值; - Warm-up:前几百步从小 LR 线性升到大 LR,稳定早期训练。
# 训练循环骨架 (PyTorch 风格)
for epoch in range(epochs):
    for xb, yb in loader:
        pred = model(xb); loss = criterion(pred, yb)
        opt.zero_grad; loss.backward      # 反向传播
        opt.step                            # 参数更新
    scheduler.step                          # 学习率调度
3.3 早停、检查点与训练恢复
- 早停(Early Stopping):监控验证指标,连续
patience轮不提升即停止,并回滚到最佳权重——防过拟合的"免费午餐"; - 检查点(Checkpoint):保存
{model_state, optimizer_state, epoch, best_metric},可从中断处恢复训练(断电/超时保护)。
if val_loss < best_loss:
    best_loss = val_loss
    torch.save({"model": model.state_dict, "opt": opt.state_dict,
                "epoch": epoch}, "best.pt")     # 保存最佳检查点
if no_improve_epochs > patience: break          # 早停
4. 评价指标体系
4.1 分类任务
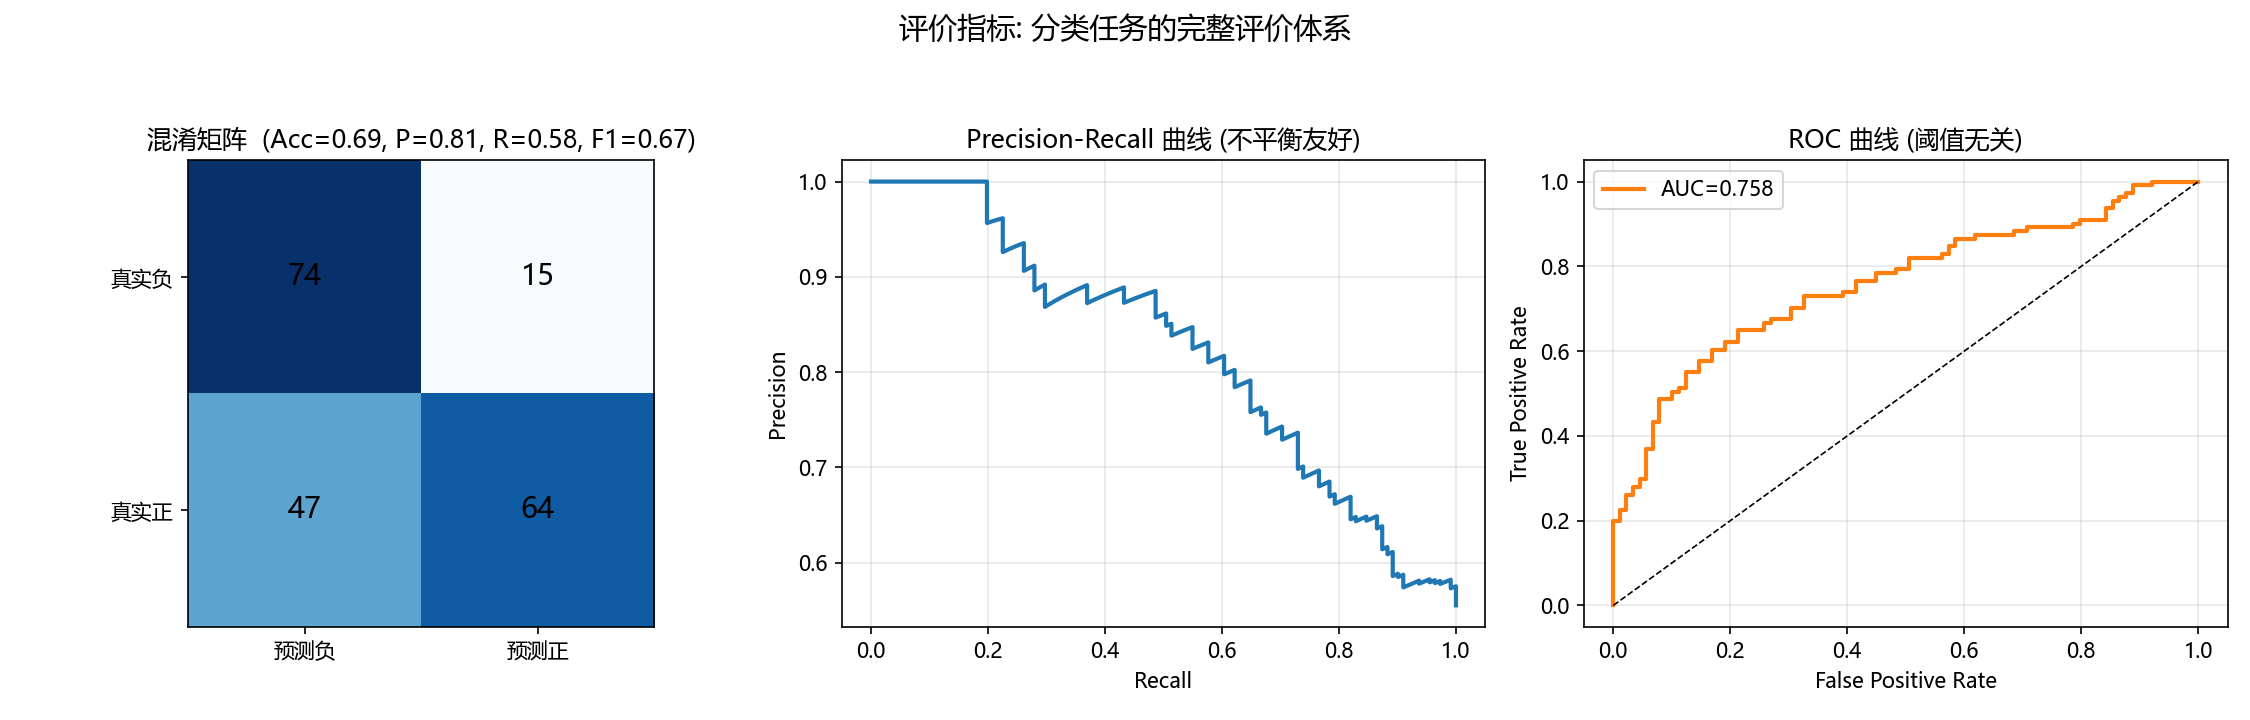
由混淆矩阵导出四大指标(TP/TN/FP/FN 为真阳/真阴/假阳/假阴):
- Precision(查准):预测为正的里面有多少真对——误报敏感场景;
- Recall(查全):真实为正的里面找回了多少——漏报敏感场景(如缺陷检测);
- F1:两者调和平均;
- ROC-AUC:阈值无关的综合能力,正负平衡时用;PR-AUC:类别不平衡时更可靠。
from sklearn.metrics import precision_recall_fscore_support, roc_auc_score
precision, recall, f1, _ = precision_recall_fscore_support(y_true, y_pred, average="binary")
auc_score = roc_auc_score(y_true, proba)
4.2 回归任务
- MSE 对大误差惩罚重(平方),MAE 对离群点更稳健;RMSE 与 y 同量纲、易解读;
- R² 越接近 1 越好,为负说明比"无脑用均值"还差。
4.3 分割 / 检测任务
- IoU(交并比):预测与真值交集 / 并集,衡量区域重叠度;
- mAP:检测的标准指标 = 不同 IoU 阈值下 AP(PR 曲线下面积)的平均;
- Dice:$2|A∩B|/(|A|+|B|)$,医学分割常用,对类别不平衡比 IoU 更敏感。
4.4 模型复杂度:参数量 Params 与计算量 FLOPs
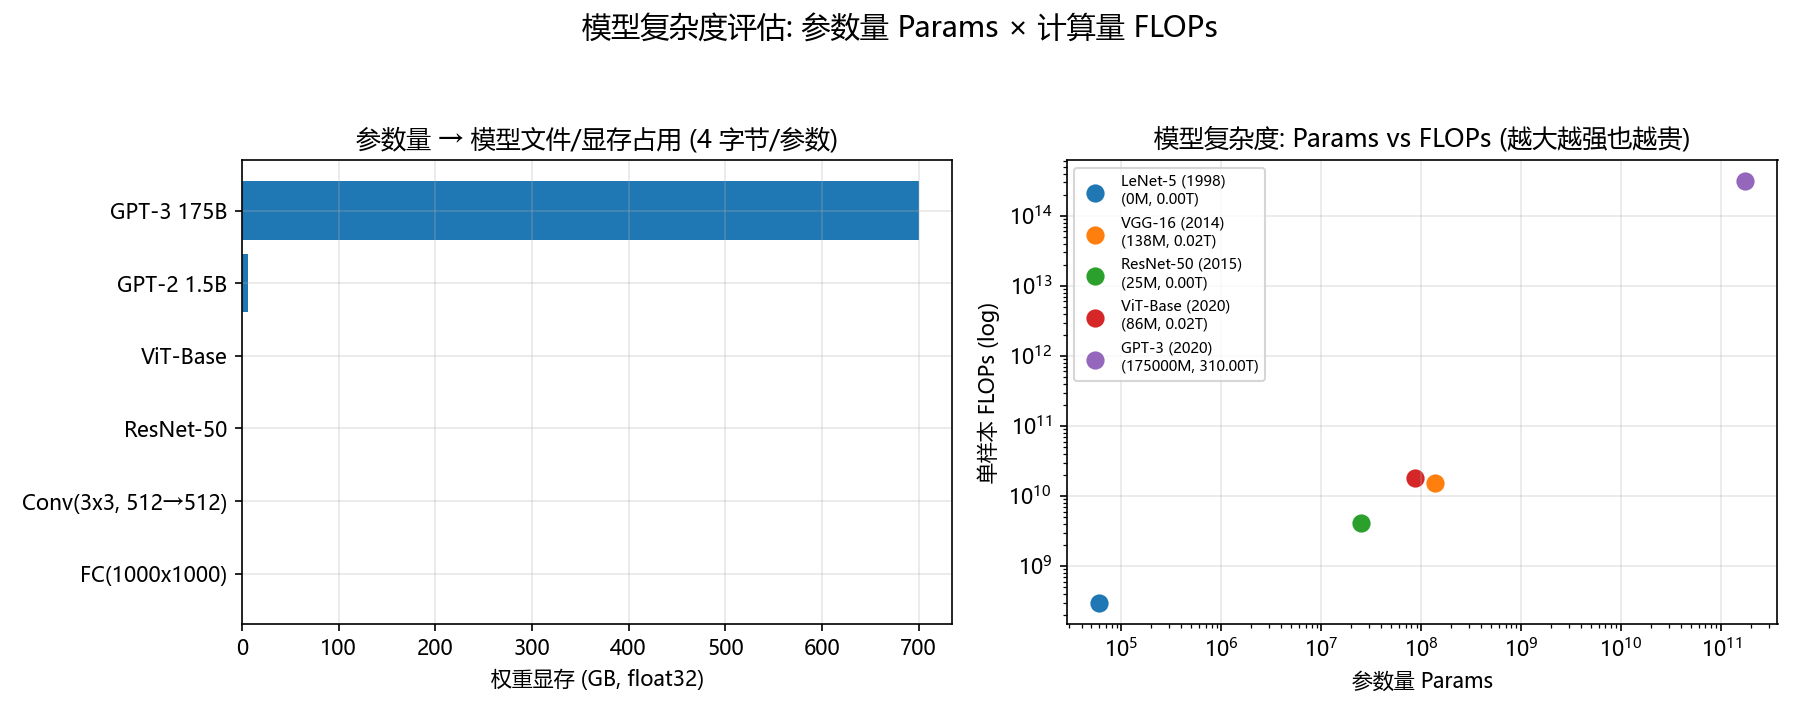
上面的指标评价「准不准」;而 Params / FLOPs 评价「多大、多贵」—— 是衡量模型复杂度、比较不同网络(如 YOLO 各版本、ResNet 各深度)的核心工程指标。
参数量(Params):所有权重 + 偏置的总个数,决定模型文件大小与显存占用。
| 层类型 | Params 公式 | FLOPs 公式(batch=B) |
|---|---|---|
| 全连接 FC | $W(m,n)+b = mn + m$ | $2mnB$ |
| 卷积 Conv | $k^2\cdot C_{in}\cdot C_{out}+C_{out}$ | $2k^2 C_{in} C_{out} h w B$ |
| 多头注意力 MHA | $4d^2$(Q/K/V/输出四组 $W\in\mathbb{R}^{d\times d}$) | $O(d^2)$ 每样本 |
推导要点:Params 只由网络结构决定(与输入尺寸无关);FLOPs 还随输入分辨率 与 batch 变化。两者经常严重不对等——卷积层 FLOPs 巨大但 Params 少, 全连接层 Params 巨大;分类头往往占据大部分 Params。
显存占用:权重字节数 ≈ Params × 字节数/参数(float32 = 4 B,半精度 = 2 B)。 训练还需梯度 + 优化器状态 + 激活缓存,实际开销约为权重的 2~4 倍。
# 手工估算: Params 与 FLOPs (numpy, 无需框架)
def conv_params(k, c_in, c_out):  return k*k*c_in*c_out + c_out
def conv_flops(k, c_in, c_out, h, w, B):
    return 2 * k*k * c_in * c_out * h * w * B
def fc_params(n_in, n_out):       return n_in*n_out + n_out
def fc_flops(n_in, n_out, B):     return 2 * n_in * n_out * B

# 小 CNN (输入 3x224x224): 三层卷积 + 两层全连接
total_params = 0
for k, ci, co, h, w in [(3,3,64,224,224), (3,64,128,112,112), (3,128,256,56,56)]:
    total_params += conv_params(k, ci, co)
print(f"卷积层 Params ≈ {total_params/1e3:.0f}K")   # 卷积仅 ~0.37M
# 而分类头 FC(256·28·28, 1024) 一个就有 ~205M —— 全连接是"参数大户"
Params 的"另一面":参数量大 ≠ 模型好。ResNet-50(25M)优于 VGG-16(138M), 因为后者几乎把所有参数花在了冗余的全连接层上。评估时应同时看 Params、FLOPs、 精度、延迟四个维度,而非单看参数量。
# PyTorch 实际统计
def count_params(model):
    return sum(p.numel for p in model.parameters)   # 含 bias 的全部参数
# 或用 thop.profile(model, inputs=(x,)) 一行同时输出 Params 与 FLOPs
5. 训练避坑指南
5.1 过拟合 vs 欠拟合
| 状态 | 训练误差 | 验证误差 | 诊断信号 | 解法矩阵 |
|---|---|---|---|---|
| 欠拟合 | 高 | 高 | 两者都高且接近 | 加大模型/特征、减小正则、延长训练 |
| 恰好 | 低 | 低 | 两者都低 | ✓ |
| 过拟合 | 很低 | 上升 | 训练降、验证升(发叉) | 加数据/增强、加正则 L2/Dropout、早停、降模型容量 |
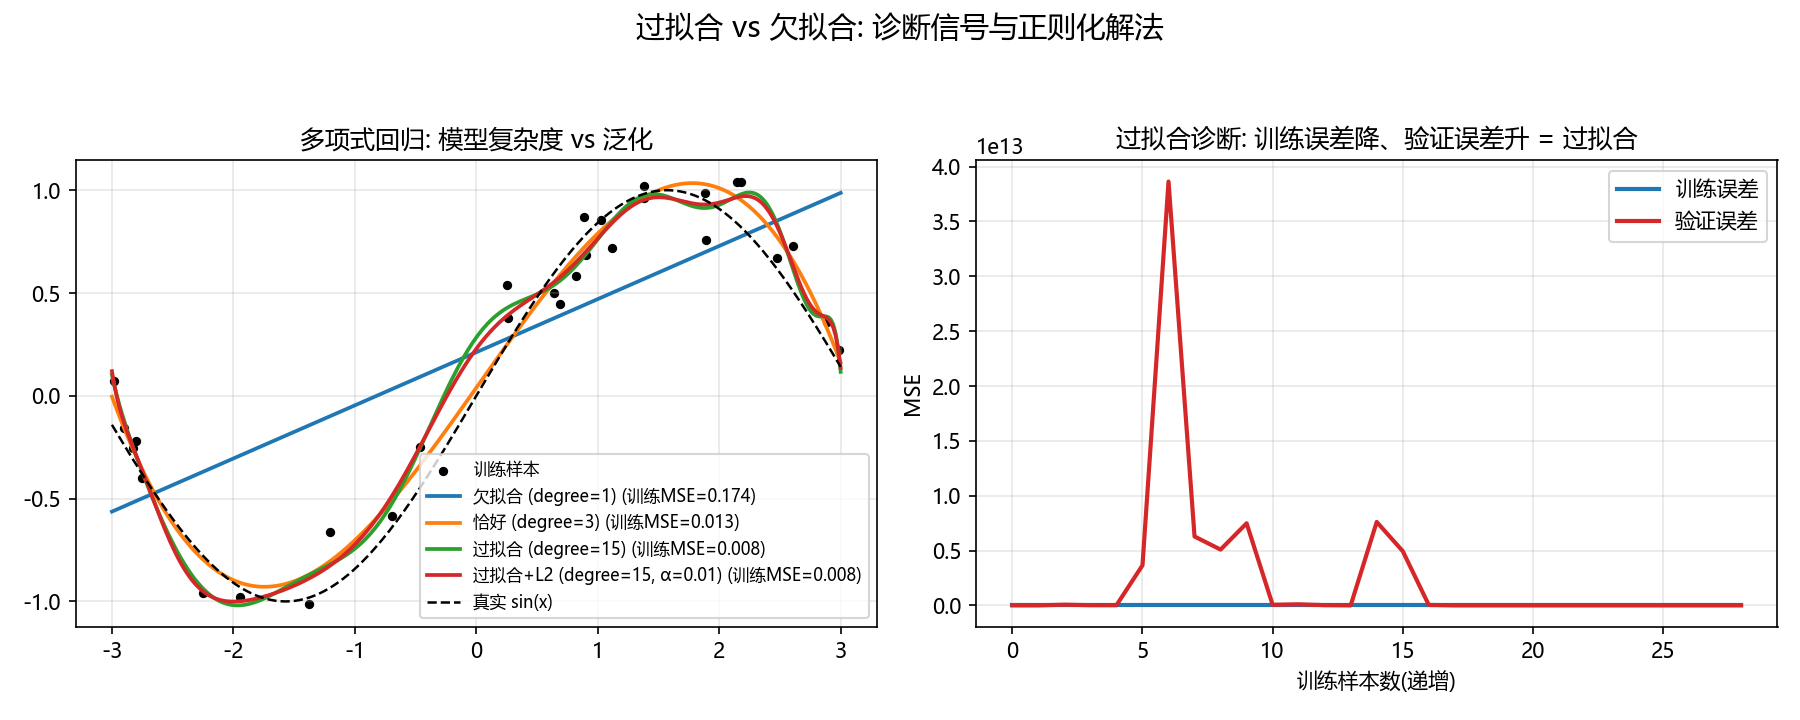
金句:模型容量 ↑ → 训练误差降,但验证误差先降后升(偏差-方差权衡)。 15 次多项式几乎拟合每个点(训练 MSE 极小),但验证误差大幅反弹——即过拟合。
5.2 梯度灾难与梯度裁剪
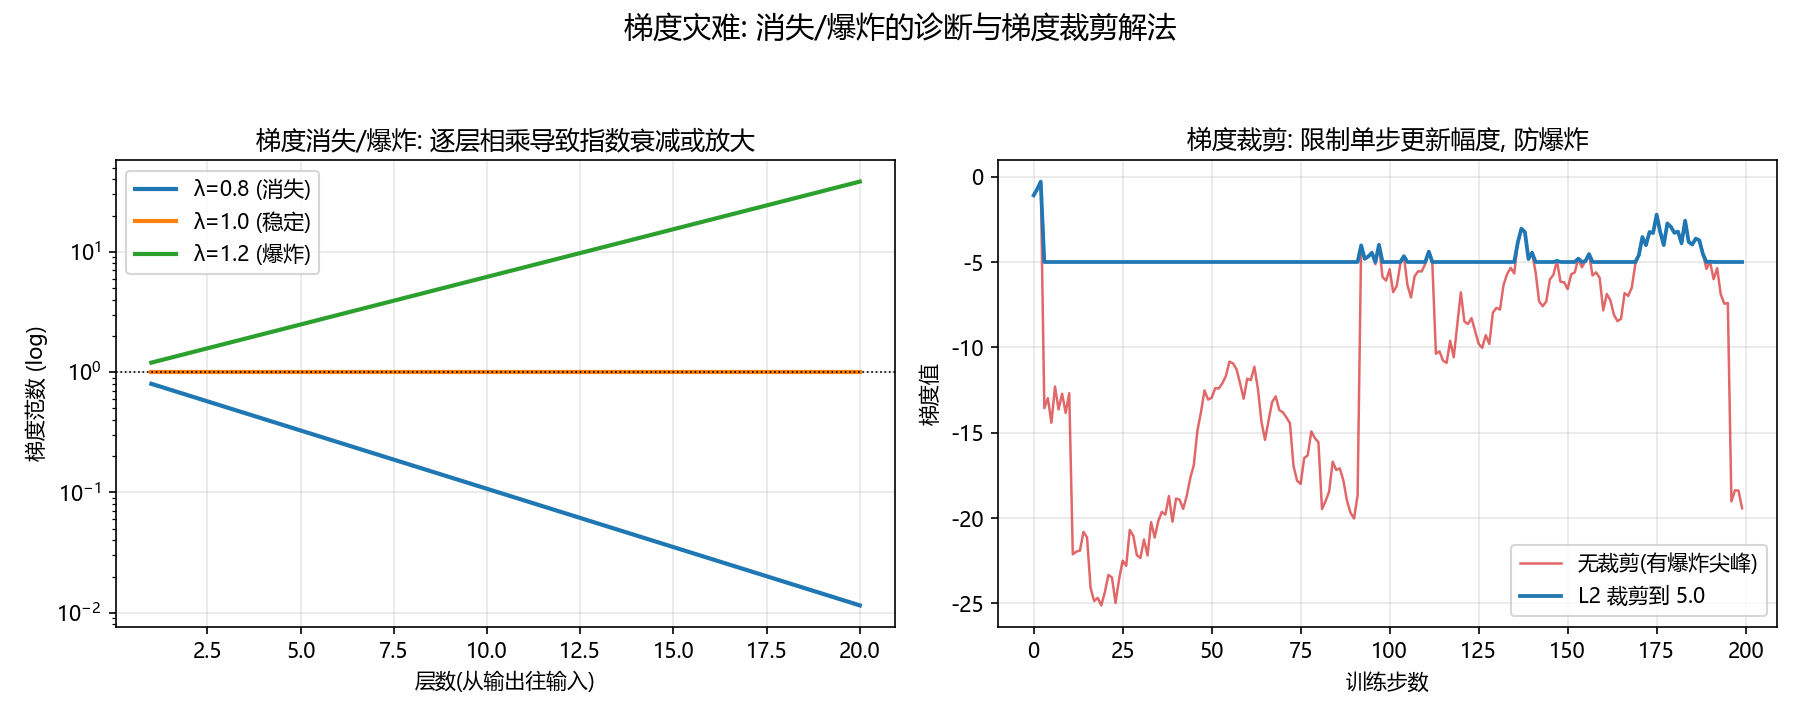
深层网络中梯度逐层相乘:若权重谱半径 λ 略大于 1 → 梯度指数放大(爆炸); 略小于 1 → 梯度指数衰减(消失)。
梯度裁剪(Gradient Clipping):把梯度的 L2 范数限制在阈值内,防爆炸:
# PyTorch 梯度裁剪
torch.nn.utils.clip_grad_norm_(model.parameters, max_norm=5.0)
缓解梯度消失:ReLU 系激活、残差连接、BatchNorm、合理的初始化(见 1.2)。
5.3 学习率陷阱与正则化对比
| 学习率 | 症状 | 处理 |
|---|---|---|
| 过大 | 损失震荡、发散 | 减小 LR 或用 Warm-up |
| 过小 | 损失缓慢停滞 | 增大 LR 或用 Cosine 回升 |
| 适中但停滞 | 陷入局部极小/鞍点 | ReduceLROnPlateau 或 Adam 等自适应优化器 |
正则化效果对比(抑制过拟合的四种手段,可叠加):
| 方法 | 机制 | 适用 |
|---|---|---|
| L2 Weight Decay | 惩罚大权重 +λ‖W‖² | 几乎所有模型 |
| Dropout | 训练时随机丢弃神经元 | 全连接/大模型 |
| Early Stopping | 验证不再提升即停 | 一切训练 |
| 数据增强 | 制造多样本 | 视觉任务首选 |
逻辑链回顾:数据预处理(第2章)→ 参数设置(第1章)→ 训练执行(第3章)→ 效果评价(第4章)→ 问题排查(第5章)。训练不顺时,先查评价指标定位是 欠/过拟合,再回退到对应章解决。
6. 附录:运行演示脚本
| 章节 | 脚本 | 输出图 |
|---|---|---|
| 1.2 初始化 | code/demo20_init.py | figures/fig_train_init.png |
| 3.2 学习率调度 | code/demo21_lr.py | figures/fig_train_lr.png |
| 2.2 数据增强 | code/demo22_augment.py | figures/fig_train_augment.png |
| 2.3 类别不平衡 | code/demo23_focal.py | figures/fig_train_imbalance.png |
| 5.1 过拟合 | code/demo24_overfit.py | figures/fig_train_overfit.png |
| 5.2 梯度灾难 | code/demo25_gradient.py | figures/fig_train_gradient.png |
| 4.1 评价指标 | code/demo26_metrics.py | figures/fig_train_metrics.png |
| 4.4 模型复杂度 | code/demo27_params_flops.py | figures/fig_train_params.png |
# 进入 code 目录后, 可逐个运行 (依赖: numpy, matplotlib, scikit-learn, torchvision 部分可选)
python demo20_init.py
python demo21_lr.py
# ... 依次类推
衔接说明:本文的梯度下降/反向传播直接来自
图形学与AI基础.md第 8 节; 评价指标中的 Precision/Recall 正是 YOLO 等检测网络(图形识别第五层)的 标准评价方式。会训练模型,才能让前面所有算法真正落地。