123456789101112131415161718192021222324252627282930313233343536373839404142434445464748495051525354555657585960616263646566676869707172737475767778798081828384858687888990919293949596979899100101102 |
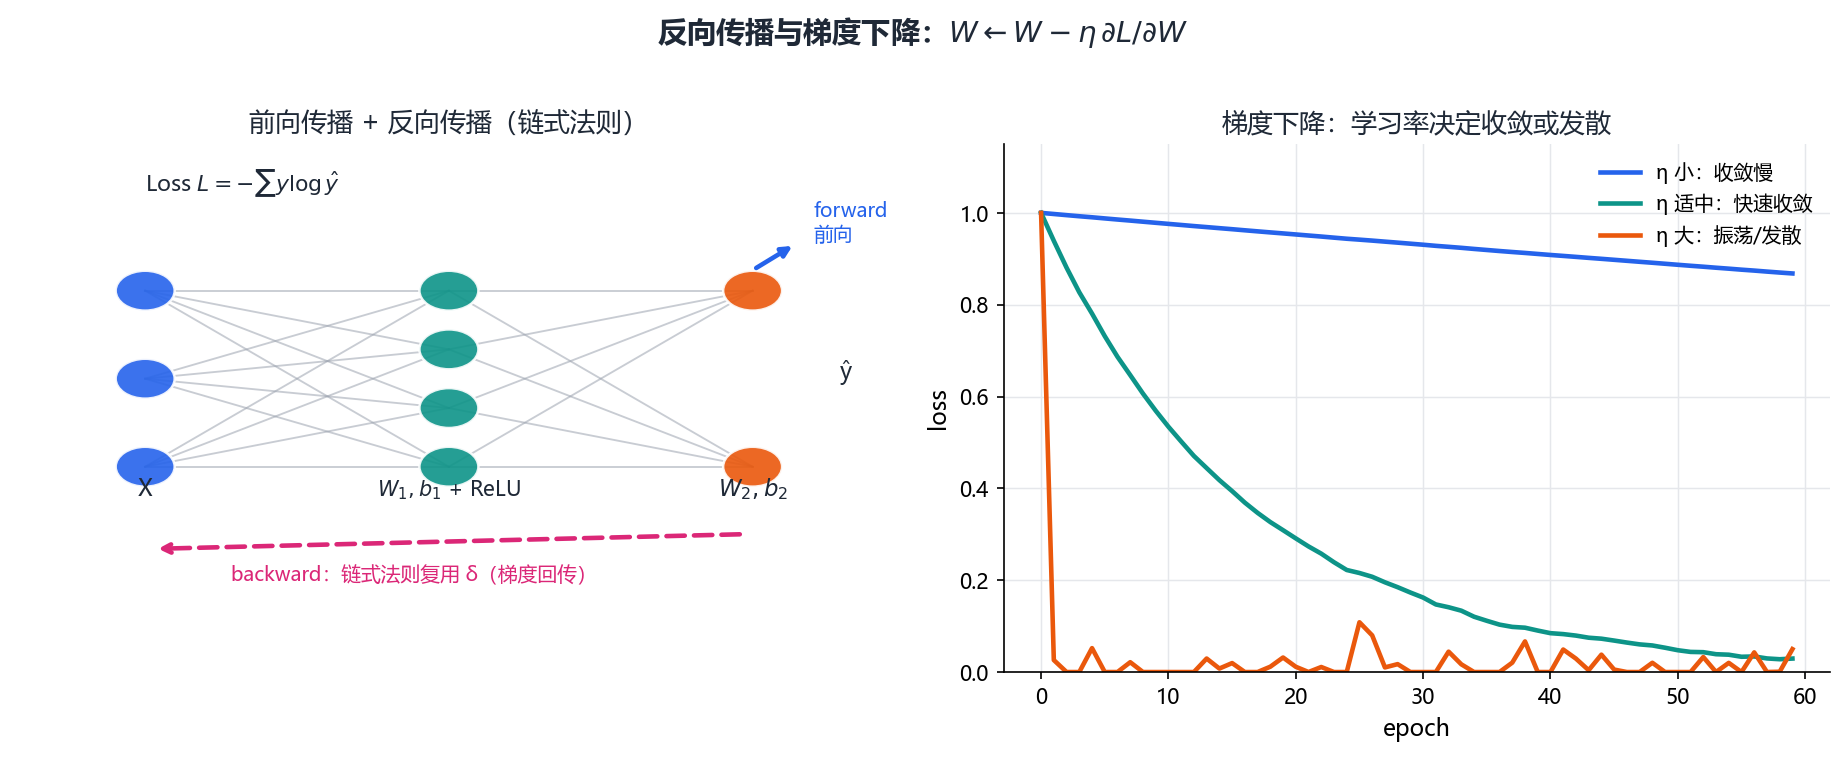
"""演示18: 反向传播 + 梯度下降 — 模型训练的"引擎"。

手写一个 2 层全连接网络在 MNIST 子集(或合成两类点)上训练:
1. 前向传播: y = softmax(W2·relu(W1·x + b1) + b2)
2. 反向传播: 链式法则求梯度
3. 梯度下降更新权重
画出损失曲线 + 决策边界, 并展示不同学习率的影响。
"""
import os
import numpy as np
import matplotlib.pyplot as plt
from figure_style import figures_dir, configure

configure()

OUT = figures_dir()
os.makedirs(OUT, exist_ok=True)


def relu(x):
    return np.maximum(0, x)


def softmax(x):
    e = np.exp(x - x.max(axis=1, keepdims=True))
    return e / e.sum(axis=1, keepdims=True)


def forward(X, W1, b1, W2, b2):
    z1 = X @ W1 + b1
    a1 = relu(z1)
    z2 = a1 @ W2 + b2
    return softmax(z2), a1


def train(X, Y, lr, steps=400, hidden=8):
    np.random.seed(0)
    n, d = X.shape
    W1 = np.random.randn(d, hidden) * 0.5
    b1 = np.zeros(hidden)
    W2 = np.random.randn(hidden, 2) * 0.5
    b2 = np.zeros(2)
    losses = []
    for _ in range(steps):
        probs, a1 = forward(X, W1, b1, W2, b2)
        loss = -np.mean(np.sum(Y * np.log(probs + 1e-9), axis=1))
        losses.append(loss)

        # ---- 反向传播 (链式法则) ----
        dz2 = probs - Y                       # 输出层梯度 (softmax + 交叉熵 合并)
        dW2 = a1.T @ dz2 / n
        db2 = dz2.mean(axis=0)
        da1 = dz2 @ W2.T
        dz1 = da1 * (a1 > 0)                  # relu 导数
        dW1 = X.T @ dz1 / n
        db1 = dz1.mean(axis=0)

        # ---- 梯度下降更新 ----
        W1 -= lr * dW1; b1 -= lr * db1
        W2 -= lr * dW2; b2 -= lr * db2
    return losses, (W1, b1, W2, b2)


# 两类环状数据(非线性可分, 需要隐藏层)
rng = np.random.default_rng(1)
t1 = rng.uniform(0, 2 * np.pi, 150)
X1 = np.c_[0.9 * np.cos(t1), 0.9 * np.sin(t1)] + rng.normal(0, 0.1, (150, 2))
X2 = rng.uniform(-0.45, 0.45, (150, 2)) + rng.normal(0, 0.08, (150, 2))
X = np.vstack([X1, X2])
Y = np.zeros((300, 2)); Y[:150, 0] = 1; Y[150:, 1] = 1   # one-hot

fig, axes = plt.subplots(1, 2, figsize=(11, 4.8))

# 不同学习率
for lr, color in [(0.05, "tab:green"), (0.5, "tab:blue"), (3.0, "tab:red")]:
    losses, _ = train(X, Y, lr)
    axes[0].plot(losses, color=color, label=f"lr={lr}")
axes[0].set_xlabel("迭代"); axes[0].set_ylabel("损失")
axes[0].set_title("梯度下降: 学习率对收敛的影响")
axes[0].legend(); axes[0].grid(alpha=0.3)

# 训练好的模型 + 决策边界
losses, (W1, b1, W2, b2) = train(X, Y, 0.5)
axes[1].scatter(X[:150, 0], X[:150, 1], c="tab:blue", s=8, label="环类")
axes[1].scatter(X[150:, 0], X[150:, 1], c="tab:orange", s=8, label="心部")
xx = np.linspace(-1.4, 1.4, 80); yy = np.linspace(-1.4, 1.4, 80)
Z = np.zeros((80, 80))
for i, xv in enumerate(xx):
    for j, yv in enumerate(yy):
        p, _ = forward(np.array([[xv, yv]]), W1, b1, W2, b2)
        Z[i, j] = p[0, 0]
axes[1].contourf(xx, yy, Z, levels=20, cmap="coolwarm", alpha=0.35)
axes[1].contour(xx, yy, Z, levels=[0.5], colors="k", lw=1.5)
axes[1].set_title("2 层网络(relu 隐藏层)学到非线性决策边界")
axes[1].legend(); axes[1].set_aspect("equal")

fig.suptitle("反向传播(链式法则) + 梯度下降: 神经网络训练引擎", fontsize=14)
fig.tight_layout(rect=(0, 0, 1, 0.93))
out = os.path.join(OUT, "fig_ai_backprop.png")
fig.savefig(out, dpi=150)
print(f"最终损失 {losses[-1]:.4f} -> {out}")
|