原理公式
感知机:对输入 x 做线性加权求和,再过一个阈值函数:
学习规则(错误驱动,来自 Rosenblatt 1958):每次遇到错分样本就沿使损失减小的方向更新:
推导要点:
y(wᵀx+b) > 0表示分类正确。错分时更新规则让w朝正确方向旋转, 最终线性可分数据一定能收敛。局限:单层感知机无法处理 XOR 等非线性问题—— 这正是引入隐藏层(多层网络)与激活函数的动机。
5.1 激活函数——非线性的来源
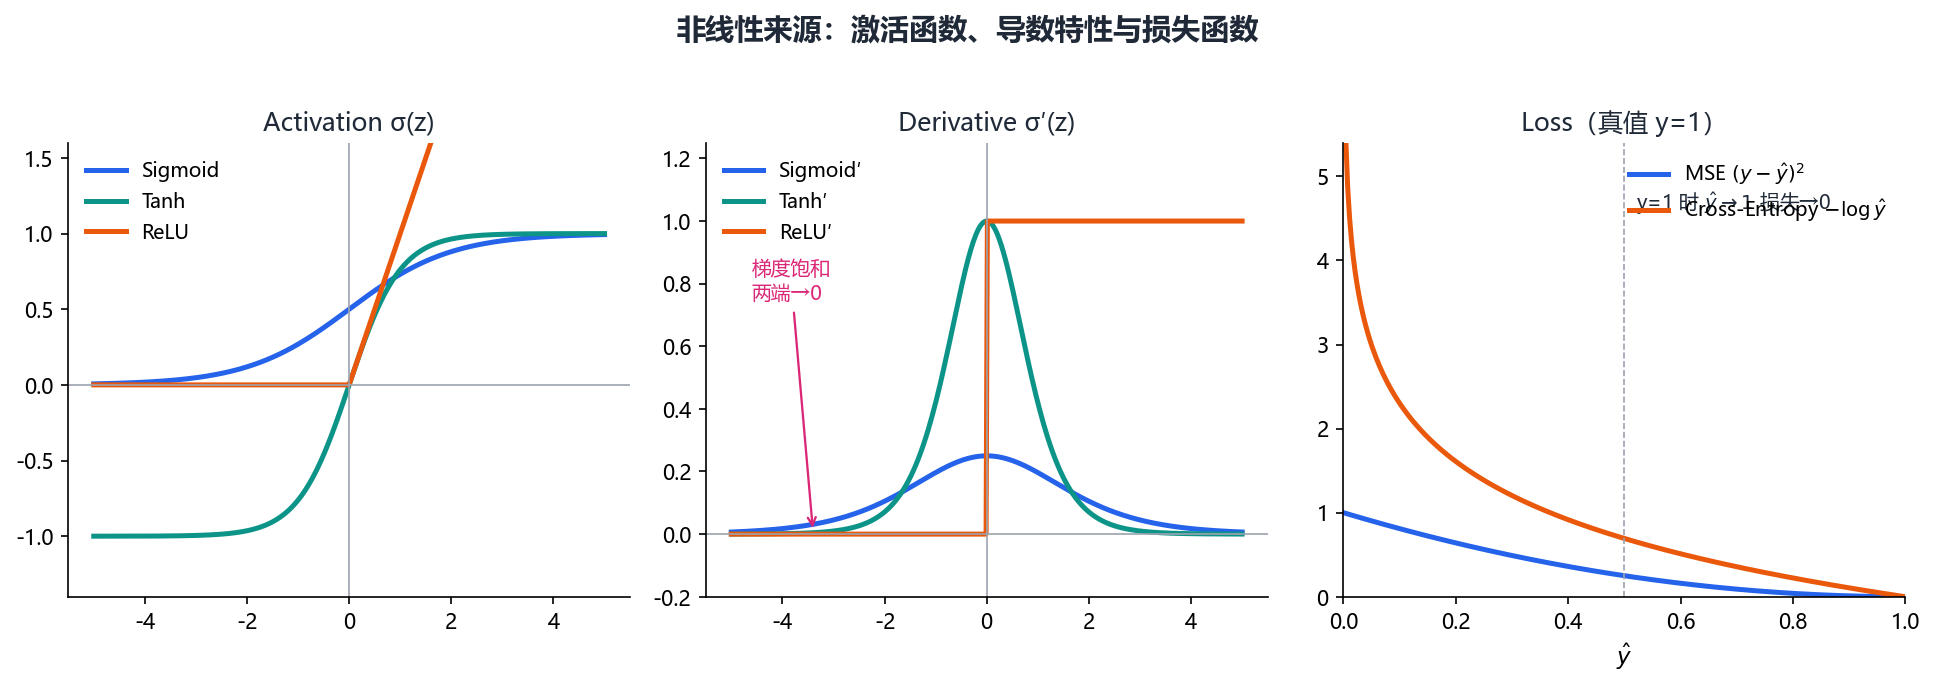
单层感知机的 sign 是硬阈值,无法近似任意函数。把神经元输出经过一个激活函数 σ(·) 引入非线性,是深层网络表达能力的来源:
| 激活函数 | 公式 | 特性 |
|---|---|---|
| Sigmoid | $\sigma(z)=\dfrac{1}{1+e^{-z}}$ | 输出 (0,1),适合概率;但梯度饱和 |
| ReLU | $\sigma(z)=\max(0,z)$ | 计算快,缓解梯度消失;但可能「死亡」(负区间梯度为 0) |
| Tanh | $\sigma(z)=\dfrac{e^{z}-e^{-z}}{e^{z}+e^{-z}}$ | 输出 (−1,1),零中心化 |
推导要点:Sigmoid 的导数
σ'(z)=σ(z)(1−σ(z)),两端趋近 0 → 梯度饱和; ReLU 的导数在负区间为 0 → 该神经元可能永远不再激活(死亡 ReLU)。 理解这些,才能看懂第 8 节反向传播中dz1 = da1 * (a1 > 0)的来源。
5.2 全连接层(FC)——多个感知机并联/级联
全连接层将多个感知机并联,并用激活函数包装成矩阵形式:
其中 W ∈ R^{m×n} 为权重矩阵,m 为输出维度(神经元数),n 为输入维度。
推导要点:每一行
W就是一个感知机的权重,m行就是m个并联神经元; 多层全连接级联即「多层感知机 MLP」,配上非线性激活即可逼近任意连续函数 (万能逼近定理)。
5.3 损失函数——训练的目标
训练要最小化「预测与真实的差距」,即损失函数:
- 均方误差(MSE)(回归):$$L = \frac{1}{N}\sum_{i=1}^{N}\left(y_i - \hat{y}_i\right)^2$$
- 交叉熵(Cross-Entropy)(分类):$$L = -\sum_{i} y_i \log \hat{y}_i$$
推导要点:MSE 假设误差服从高斯分布(L2 目标);交叉熵来自极大似然估计, 对「概率输出 + 硬标签」的梯度更友好——这就是第 8 节反向传播里
dz2 = probs - Y能一步合并的原因(softmax + 交叉熵的复合导数恰好是这个差)。
重难点核心代码(code/demo15_perceptron.py、code/demo19_activation_loss.py)
w = np.zeros(3); Xh = np.hstack([np.ones((len(X),1)), X])   # 增广齐次坐标
for _ in range(200):
    for xi, yi in zip(Xh, y):
        if yi * (xi @ w) <= 0:          # 错分样本
            w = w + 0.1 * yi * xi        # 学习规则

# 全连接层 + 激活 (numpy 实现, 一个隐藏层)
def fc_forward(X, W1, b1, W2, b2):
    z1 = X @ W1 + b1; a1 = np.maximum(0, z1)   # 全连接 + ReLU 激活
    z2 = a1 @ W2 + b2; return softmax(z2)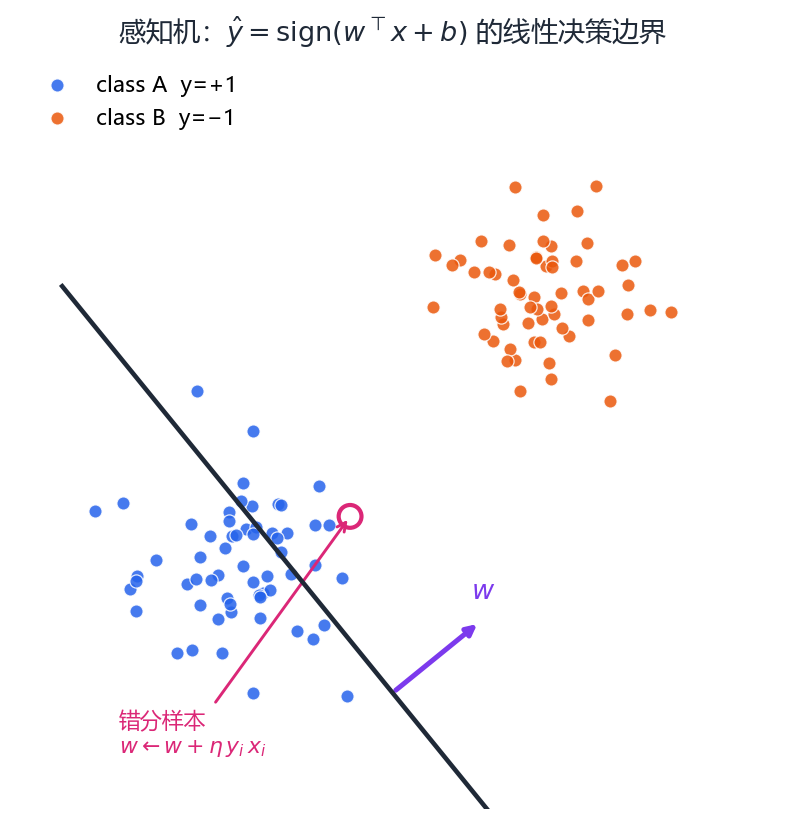
与已有文档衔接:
图形识别-经典示例与代码.md中提到的 YOLO、L-CNN、HAWP 等 网络的「头部(Head)」通常就是全连接层,负责将卷积提取的特征映射到最终的 图元参数或类别概率——回归头输出坐标/尺寸(对应 MSE),分类头输出类别 概率(对应交叉熵)。