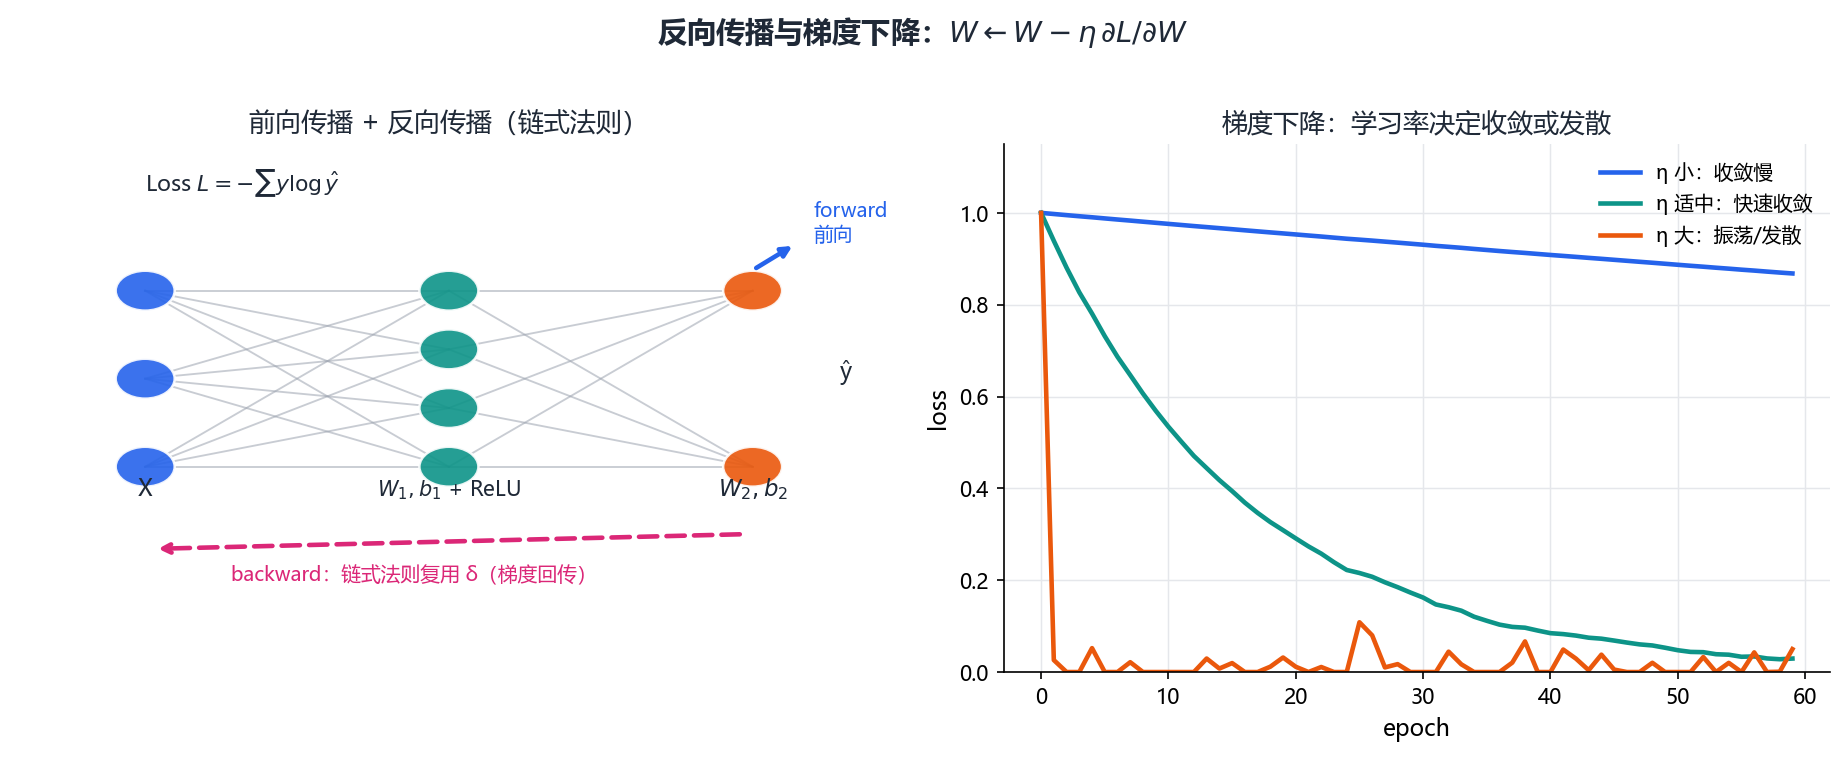
原理公式
前向传播(2 层网络):z₁ = XW₁+b₁ → a₁ = ReLU(z₁) → z₂ = a₁W₂+b₂ → ŷ = softmax(z₂)
损失(交叉熵):L = -Σ y log ŷ
梯度下降更新:W ← W − η·∂L/∂W,其中梯度由反向传播(链式法则)计算:
$$\frac{\partial L}{\partial W_2} = a_1^\top \delta_2,\qquad
\delta_2 = \hat{y} - y$$
$$\frac{\partial L}{\partial W_1} = X^\top \delta_1,\qquad
\delta_1 = (\delta_2 W_2^\top) \circ \mathbb{1}[z_1>0]$$
推导要点:反向传播 = 从输出往输入逐层应用链式法则,复用中间结果(
δ)。 学习率η是步长:太小收敛慢,太大会震荡/发散(见演示图左图三条曲线)。
重难点核心代码(code/demo18_backprop.py)
Python
# 反向传播 (链式法则, 手动实现)
dz2 = probs - Y                       # 输出层梯度 (softmax+交叉熵已合并)
dW2 = a1.T @ dz2 / n; db2 = dz2.mean(axis=0)
da1 = dz2 @ W2.T
dz1 = da1 * (a1 > 0)                  # ReLU 导数: 正区间为 1
dW1 = X.T @ dz1 / n; db1 = dz1.mean(axis=0)
# 梯度下降更新
W1 -= lr * dW1; b1 -= lr * db1; W2 -= lr * dW2; b2 -= lr * db2